蒸蒸日上。看看能不能一次实验记录就完成Exercise 4。
实验记录
NewHeapFile
完事开头难,对于heap_file而言也一样。
创建新的堆文件?不太懂,先来看看heapfile的结构
type HeapFile struct {
	// TODO: some code goes here
	// HeapFile should include the fields below;  you may want to add
	// additional fields
	bufPool *BufferPool
	sync.Mutex

}
一个互斥锁和一个自定义的BufferPool,而BufferPool是什么?在下面的注释有提到
// - bp: the BufferPool that is used to store pages read from the HeapFile那么heapfile通过bufPool管理多个页,大概懂了之后接下来就来实现NewHeapFile。看下注释,heapfile有字段,有HeapFile的文件名,那么还得往heapfile的struct里头加点东西。
type HeapFile struct {
	// TODO: some code goes here
	// HeapFile should include the fields below;  you may want to add
	// additional fields
	bufPool *BufferPool
	sync.Mutex
	Desc     *TupleDesc
	FromFile string
}
那NewHeapFile也很好写了,注释里还提到如果fromFile不存在说明db还没有heapFile,那我们还需要自己新建一个fromFile。然后我们直接返回即可。别忘了file.close()。
func NewHeapFile(fromFile string, td *TupleDesc, bp *BufferPool) (*HeapFile, error) {
	// TODO: some code goes here
	file, _ := os.OpenFile(fromFile, os.O_RDWR|os.O_CREATE, 0666)
	defer file.Close()
	return &HeapFile{FromFile: fromFile, Desc: td, bufPool: bp}, nil //replace me
}
接下来是NumPages,怎么计算heapfile中有多少页呢?我想的是直接从BufferPool拿不就好了….但markdown里面写了要求,要我们通过fromFile的文件大小(File.Stat)计算得到numpages。
然后我就在这上面花了一天的时间修bug,接下来慢慢讲吧。
实验bug修正
numpages=0
算numpages不难。代码很简单。
func (f *HeapFile) NumPages() int {
	// TODO: some code goes here
	fileInfo, err := os.Stat(f.FromFile)
	if err == nil {
		filesize := int(fileInfo.Size())
		return filesize / PageSize
	}
	return 0 //replace me
}
但是我发现不管怎么算numpages一直是0,几次debug之后我发现pagesize肯定没问题,一直是4096。那么问题就在于int(filesize)/pagesize这一步。
为什么是0?既然pagesize不为0那只有可能是filesize为0。当然如果你还没有往后写的话pagesize肯定是0。但是我debug之后发现pagesize=48,说明pagesize也不等于0。那么问题就出在两个数相除这里。
于是我想了想,在上一节的heap_page中,我们是怎么把tuple写入缓冲区,又读取缓冲区的?
按我上一节的思路,有多少记录就写多少记录。那么问题来了,heap page最后一定有4096字节吗?不一定,不是吗?有多少写多少,那剩下的空间完全就是空的。
所以我们还需要在剩下的位置填上0补全page直到它有4096字节。且读取的时候只读取有效数据。
那么我们需要修改读写缓冲区的两个函数。需要注意的是实验提到了:从缓冲区读回记录的时候,rid不一定和写入记录的rid相等,主要是因为tuple本身就是无序存放在heap_page里的。
写者注
一个page写入buffer之后,该buffer可能由其它新的page来读取。所以不能通过在page结构中加一个usefulBytes来判断哪些数据有效–因为其它新的page拿不到这个值。
func (h *heapPage) toBuffer() (*bytes.Buffer, error) {
	// TODO: some code goes here
	bytesBuffer := new(bytes.Buffer)
	err := binary.Write(bytesBuffer, binary.LittleEndian, h.Hdr)
	if err != nil {
		return nil, err
	}
	for _, tuple := range h.Tuple {
		if tuple != nil {
			err := tuple.writeTo(bytesBuffer)
			if err != nil {
				return nil, err
			}
		}
	}
	paddingSize := 4096 - bytesBuffer.Len()
	paddingBytes := make([]byte, paddingSize)
	_, err = bytesBuffer.Write(paddingBytes)
	if err != nil {
		return nil, err
	}

	return bytesBuffer, nil //replace me
}
我做完之后发现initFromBuffer还有个bug。之前读取的时候错误的初始化了Rid,导致从磁盘中读取的第一个rid会变成了int类型的值。导致没法获取到页号pageNo。新建一个RecordID对象然后初始化即可。
rid可以不用和写入的时候一样,所以直接SlotNo直接取i就行。
func (h *heapPage) initFromBuffer(buf *bytes.Buffer) error {
	// TODO: some code goes here
	err := binary.Read(buf, binary.LittleEndian, &h.Hdr)
	if err != nil {
		return err
	}
	for i := 0; i < int(h.Hdr.UsedSlots); i++ {
		tuple, err := readTupleFrom(buf, h.Desc)
		if err != nil {
			return err
		}
		h.Tuple[i] = tuple
		rid := RecordID{PageNo: h.PageNo, SlotNo: i}
		h.Tuple[i].Rid = rid
	}
	return nil //replace me
}
然后自己在heap_file_test中写一个test试试,看看能不能拿到numpage=1。
func TestNumPage(t *testing.T) {
	var td = TupleDesc{Fields: []FieldType{
		{Fname: "name", Ftype: StringType},
		{Fname: "age", Ftype: IntType},
	}}
	bp := NewBufferPool(3)
	os.Remove(TestingFile)
	hf, _ := NewHeapFile(TestingFile, &td, bp)
	var t1 = Tuple{
		Desc: td,
		Fields: []DBValue{
			StringField{"sam"},
			IntField{25},
		}}
	hf.insertTuple(&t1, NewTID())
	fmt.Println(hf.NumPages())
	_ = hf
}
能拿到,说明问题解决。同时我在检查的时候发现insertTuple中高亮的地方没写return导致循环执行多次,所以这里也修改一下。
// Insert the tuple into a free slot on the page, or return an error if there are
// no free slots.  Set the tuples rid and return it.
func (h *heapPage) insertTuple(t *Tuple) (recordID, error) {
	// TODO: some code goes here
	rid := RecordID{PageNo: h.PageNo, SlotNo: 0}
	if h.Hdr.UsedSlots == h.Hdr.TotalSlots {
		return rid, errors.New("no free slots")
	}
	for i, tuple := range h.Tuple {
		if tuple == nil {
			h.Tuple[i] = t
			rid.SlotNo = i
			h.Tuple[i].Rid = rid
			h.Hdr.UsedSlots += 1
			return rid, nil
		}
	}
	return rid, errors.New("Can't insert Tuple") //replace me
}
接下来继续实验。
写者注
虽然这段写的很少,但我真的花了6个小时多的时间反复debug。bufferpool.getPage()之类的错误真的很难找出来,不过debug完之后我对godb的理解也更深了倒是真的。
实验步骤
getPage
在此之前,我们还需要回到buffer_pool中补全几段代码。因为我们接下来的操作都要和bufferpool打交道。
从getPage的注释入手,再到pageKey的注释,可以推出bufferpool通过hashmap的方式存储不同的heappage。其中key的类型为heaphash。
但是pageKey返回的是any,所以我们还是选any类型作为key。所以所以bp的结构和初始化应该为
type BufferPool struct {
	// TODO: some code goes here
	NumPages int
	Pages    map[any]*Page
}

// Create a new BufferPool with the specified number of pages
func NewBufferPool(numPages int) *BufferPool {
	// TODO: some code goes here
	return &BufferPool{NumPages: numPages, Pages: make(map[any]*Page, numPages)}
}
顺带补全pageKey
func (f *HeapFile) pageKey(pgNo int) any {

	// TODO: some code goes here
	hH := heapHash{FileName: f.FromFile, PageNo: pgNo}
	return hH

}
接下来补全getPage。如果缓冲池没有page,那就给对应的下标初始化一个page。而缓冲池的大小有NumPages决定。也就是说这个缓冲池最多存3页。
func (bp *BufferPool) GetPage(file DBFile, pageNo int, tid TransactionID, perm RWPerm) (*Page, error) {
	// TODO: some code goes here
	key := file.pageKey(pageNo)
	if bp.Pages[key] == nil {
		page, err := file.readPage(pageNo)
		if err != nil {
			return nil, err
		}
		bp.Pages[key] = page
		return bp.Pages[key], nil
	} else {
		return bp.Pages[key], nil
	}

}
至于锁和驱逐算法我决定先不管。等后续的lab实现事务的时候再一起处理。
实验步骤
完成heap_file
要想跑通heap_file_test.go的全部test,还有“亿”些代码要补全。
readPage还好,简单来说就是从磁盘读page。由于每页都一定是4096大小,所以我们可以从指定下标开始读取指定页。
func (f *HeapFile) readPage(pageNo int) (*Page, error) {
	// TODO: some code goes here
	file, _ := os.OpenFile(f.FromFile, os.O_RDWR|os.O_CREATE, 0666)
	defer file.Close()
	bytesBuffer := make([]byte, PageSize)
	_, err := file.ReadAt(bytesBuffer, int64(pageNo*PageSize))
	if err != nil {
		return nil, err
	}
	hp := newHeapPage(f.Desc, pageNo, f)
	hp.initFromBuffer(bytes.NewBuffer(bytesBuffer))
	var page Page = hp
	return &page, nil
}
insertTuple就要考虑考虑了。如果数据库文件是空的那我们得新建一个page扔进bp,再bp中对page作操作。注释还提到要把它写入磁盘(flushpage),所以代码如下
func (f *HeapFile) insertTuple(t *Tuple, tid TransactionID) error {
	// TODO: some code goes here
	inserted := false
	for i := 0; i < f.NumPages(); i++ {
		pg, err := f.bufPool.GetPage(f, i, tid, ReadPerm)
		if err != nil {
			return err
		}
		hp := (*pg).(*heapPage)
		for j := 0; j < int(hp.Hdr.TotalSlots); j++ {
			if hp.Tuple[j] == nil {
				hp.insertTuple(t)
				inserted = true
				return nil
			}
		}
	}
	if !inserted {
		//Create HeapPage, insert tuple, flush page
		hp := newHeapPage(f.Desc, f.NumPages(), f)
		hp.insertTuple(t)
		var page Page = hp
		f.flushPage(&page)
	}
	return nil //replace me

}
删除tuple也还好。首先删除肯定是从已有的tuple中挑一个删除。那么我们只需要通过每个tuple唯一不重复的rid来判断即可。
func (f *HeapFile) deleteTuple(t *Tuple, tid TransactionID) error {
	// TODO: some code goes here
	for i := 0; i < f.NumPages(); i++ {
		pg, err := f.bufPool.GetPage(f, i, tid, ReadPerm)
		if err != nil {
			return err
		}
		hp := (*pg).(*heapPage)
		err = hp.deleteTuple(t.Rid)
		if err != nil {
			return err
		}
	}
	return nil //replace me
}
接下来就是flushpage。把page写到磁盘上。没啥能讲的。
func (f *HeapFile) flushPage(p *Page) error {
	// TODO: some code goes here
	//You should write page to file(Disk)
	file, _ := os.OpenFile(f.FromFile, os.O_RDWR|os.O_CREATE, 0666)
	defer file.Close()
	//Turn page to byte array
	hp := (*p).(*heapPage)
	buffer, err := hp.toBuffer()
	if err != nil {
		return err
	}
	numOfBytes, err := file.WriteAt(buffer.Bytes(), int64(hp.PageNo*PageSize))

	_ = numOfBytes //TODO: remove this line after Debug
	return err     //replace me
}
返回desc的也很简单,直接return就行。
func (f *HeapFile) Descriptor() *TupleDesc {
	// TODO: some code goes here
	return f.Desc //replace me
}
接下来是迭代,虽然page有自己的Iterator,但在这里我们先自己实现迭代的方法(主要是方便调试)。
func (f *HeapFile) Iterator(tid TransactionID) (func() (*Tuple, error), error) {

	// TODO: some code goes here
	i := 0
	j := 0
	//var iter func() (*Tuple, error)
	return func() (*Tuple, error) {
		for i < f.NumPages() {
			pg, err := f.bufPool.GetPage(f, i, tid, ReadPerm)
			if err != nil {
				return nil, err
			}
			hp := (*pg).(*heapPage)
			for j < int(hp.Hdr.TotalSlots) {
				if hp.Tuple[j] != nil {
					tuple := hp.Tuple[j]
					j++
					return tuple, nil
				} else {
					j++
				}
			}
			j = 0
			i++
		}
		return nil, nil
	}, nil
}
实验步骤
通过heap_file_test.go
看了下test,还要补全bufferpool里面的flushAllPage。
func (bp *BufferPool) FlushAllPages() {
	// TODO: some code goes here
	for _, page := range bp.Pages {
		p := *page
		file := *p.getFile()
		file.flushPage(&p)
	}
}
补全之后直接run file test,过。(花了几天终于过了,令人感慨)

以防万一我又单独跑了每个test单元。我突然发现个很有意思的地方。
如果你同时跑多个test,由于写入的都是同一个文件,Test A和Test B最后会读到对方的数据。但是单独运行每个test单元又不会出现问题。
当然这应该不算bug,毕竟我们还没实现事务。
实验步骤
优化heap file的迭代器
匿名函数学的不够精就会像我一样,一个迭代器写半天。
func (f *HeapFile) Iterator(tid TransactionID) (func() (*Tuple, error), error) {

	// TODO: some code goes here
	i := 0
	var iter func() (*Tuple, error)

	return func() (*Tuple, error) {
		for i < f.NumPages() {
			pg, err := f.bufPool.GetPage(f, i, tid, ReadPerm)
			if err != nil {
				return nil, err
			}
			hp := (*pg).(*heapPage)
			if iter == nil {
				iter = hp.tupleIter()
			}
			t, err := iter()
			if err != nil {
				return nil, err
			}
			if t != nil {
				return t, nil
			} else {
				i++
				iter = nil
			}
		}
		return nil, nil
	}, nil
}
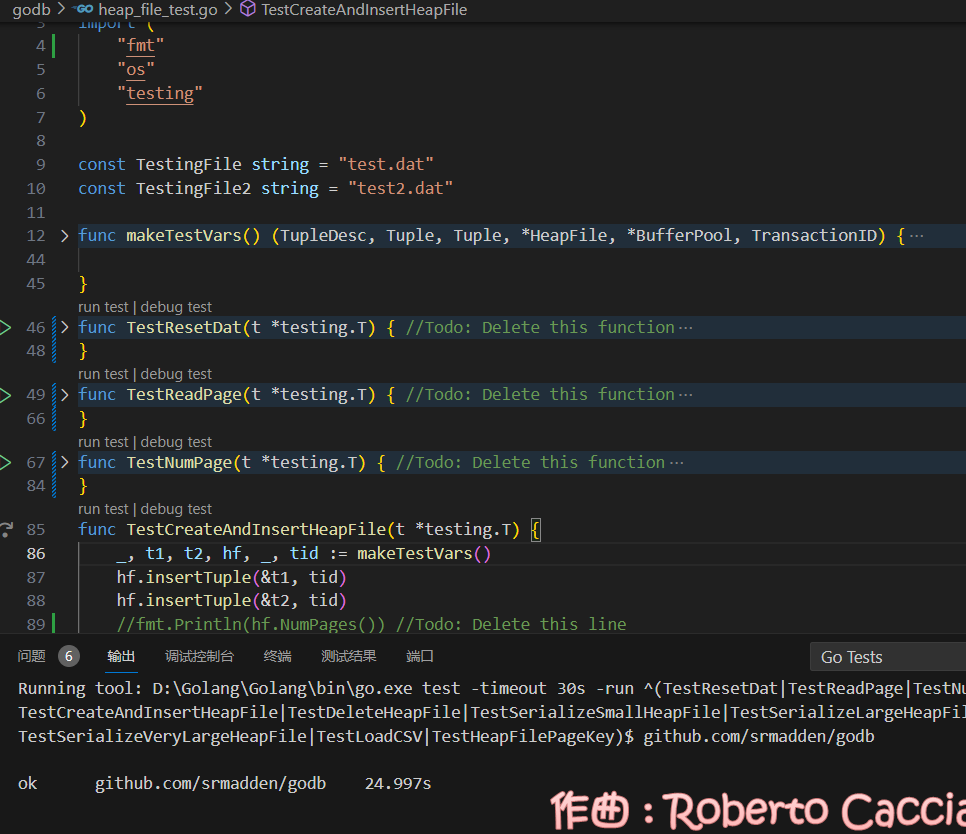
再run file test一下,全pass。
接下来lab1还剩最后一个exercise了,再接再厉咯。
